Inception lanza Mercury 3: un modelo de IA ocho veces más rápido
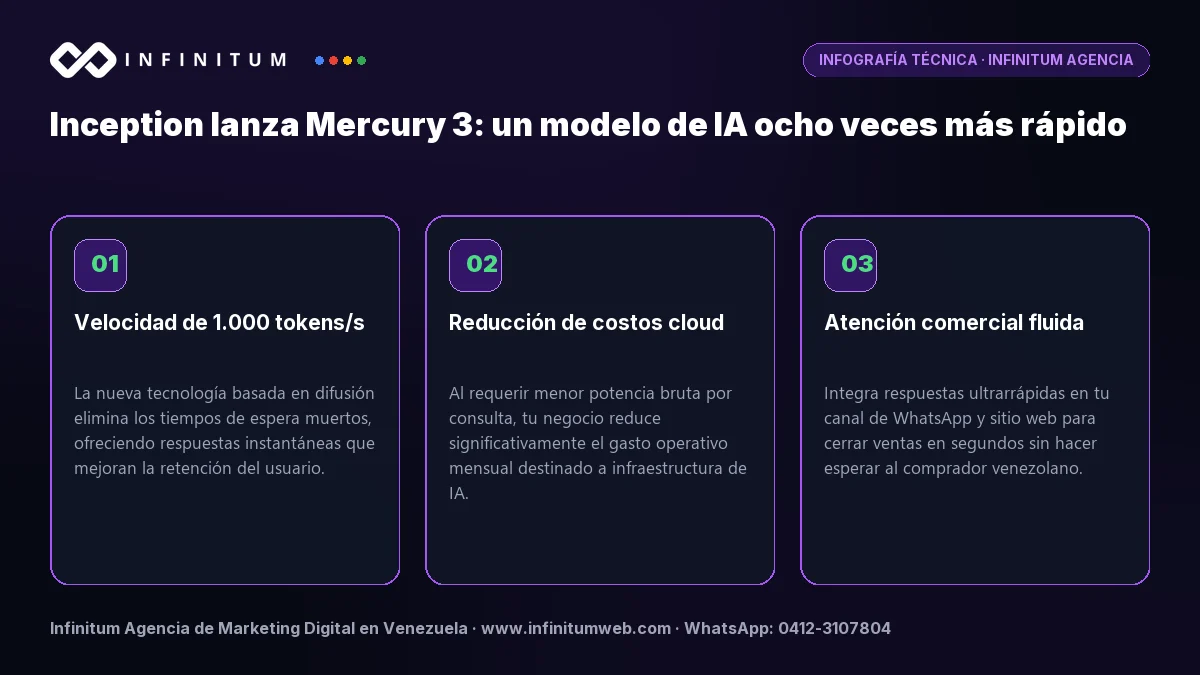
Inception ha lanzado Mercury 3, un modelo de lenguaje basado en difusión que alcanza los 1.000 tokens por segundo. Esta tecnología promete multiplicar entre 4 y 8 veces la velocidad de procesamiento actual, reduciendo drásticamente la latencia y los costos operativos en NOVEDAD al cliente y flujos B2B automatizados.
La industria de la inteligencia artificial da un salto de velocidad con el lanzamiento de Mercury 3 por parte de Inception. Al superar los 1.000 tokens por segundo, este modelo revoluciona la eficiencia operativa, permitiendo a las empresas procesar grandes volúmenes de datos sin las tradicionales demoras de los servidores masivos.
Qué acaba de cambiar exactamente
Inception ha presentado Mercury 3, un LLM fundamentado en técnicas de difusión que compite directamente con modelos consolidados como Luna y Haiku, pero con una ventaja diferencial contundente: opera entre 4 y 8 veces más rápido.
Esta arquitectura genera aproximadamente 1.000 tokens por segundo, eliminando los cuellos de botella de procesamiento que limitaban la inmediatez en asistentes conversacionales y análisis masivos de datos en tiempo real.
Por qué esto cambia las reglas del juego en Inteligencia Artificial Aplicada
Hasta ahora, escalar la velocidad de respuesta exigía infraestructura pesada y costos de cómputo elevados que impactaban la rentabilidad de las operaciones digitales. La arquitectura de Mercury 3 demuestra que es posible mantener una alta capacidad de razonamiento con una eficiencia de recursos sin precedentes.
Para los negocios, esto significa respuestas instantáneas en canales de atención automatizados, menor fricción en la experiencia del usuario y una reducción drástica en la factura de procesamiento de IA.
Para organizaciones que buscan capitalizar estas tendencias con resultados medibles, apoyarse en nuestro soluciones de inteligencia artificial y automatización para empresas permite acelerar la implementación técnica y convertir la visibilidad en clientes reales.
Qué debes hacer hoy en tu negocio en Venezuela y Latinoamérica
La velocidad de procesamiento ya no es un lujo técnico, sino un estándar competitivo. Es momento de revisar tus integraciones actuales de atención al cliente y automatización en plataformas como WhatsApp para evaluar dónde la lentitud está generando fricción comercial.
En Infinitum te ayudamos a integrar modelos de alta eficiencia directamente en tus embudos de venta y ecosistemas web, asegurando que cada consulta sea respondida al instante y convertida en una oportunidad real de negocio.
Comparativa Estratégica: Enfoque Tradicional vs. Nuevo Estándar 2026
| Dimensión Operativa | Enfoque Tradicional | Nuevo Estándar 2026 | Ecosistema Infinitum |
|---|---|---|---|
| Velocidad de Respuesta | Lenta con esperas de varios segundos | Inmediata a 1.000 tokens por segundo | Optimizada para conversión instantánea |
| Costos Operativos | Elevados por consumo masivo de servidores | Eficientes gracias a modelos de difusión | Rentabilidad medida y escalable |
| Integración Comercial | Aislada sin conexión al embudo de ventas | Conectada a canales de mensajería | Ecosistema unificado web y WhatsApp |
Preguntas Frecuentes (FAQ)
1. ¿Qué es exactamente un modelo de lenguaje basado en difusión?
Es una arquitectura tecnológica alternativa a los transformadores tradicionales que permite generar texto y datos de forma sumamente acelerada, manteniendo altos niveles de precisión y contexto sin sobrecargar la infraestructura de servidores.
2. ¿Cómo se benefician las empresas en Venezuela de esta velocidad?
Permite ofrecer respuestas instantáneas en atención al cliente y soporte técnico a través de WhatsApp, evitando que los potenciales compradores abandonen la conversación por culpa de la lentitud de los sistemas automatizados tradicionales.
3. ¿Cómo implementar esta estrategia en un negocio en Venezuela o Latinoamérica?
En Infinitum analizamos tus procesos actuales de ventas y atención, seleccionamos las arquitecturas de IA más eficientes y las integramos directamente a tu sitio web y pasarelas de comunicación, con soporte local y facturación legal en bolívares.
💡 En Resumen: Lo que debes recordar
- ✓ Mercury 3 rompe la barrera de velocidad en los modelos de lenguaje mediante difusión avanzada.
- ✓ La velocidad extrema reduce los costos de infraestructura y optimiza la experiencia de usuario en tiempo real.
- ✓ Audita tus flujos de atención actuales y adopta arquitecturas de IA veloces para evitar la pérdida de clientes.
¿Quieres automatizar la atención y ventas de tu negocio con Agentes de IA?
Implementamos asistentes inteligentes en Instagram, Web y WhatsApp con base de conocimiento propia y cero riesgo de bloqueos. Facturación fiscal SENIAT (RIF: J-50392044-0) a tasa oficial BCV.
🚀 ¡Nunca pares de aprender!
Descubre más artículos clave en nuestro blog para seguir impulsando tu conocimiento: