OpenAI y Anthropic recortan 80% precios de IA por modelos abiertos
Un exhaustivo análisis del científico de datos Max Woolf revela que OpenAI y Anthropic han reducido hasta un 80% los precios de sus principales modelos de lenguaje en solo cuatro meses. Esta guerra de precios responde a la presión de modelos de pesos abiertos como DeepSeek Flash V4.1 y Kimi K3.1 Pro de Moonshot AI, sumada a la facilidad de migración que ofrecen enrutadores como OpenRouter.
Radar Discover · Multi-Fuente
📚 5 medios y reportes primarios verificados
Verificación Periodística E-E-A-T
Este análisis contrasta y sintetiza datos técnicos, informes oficiales y cobertura periodística de medios de referencia:
- OpenAI redujo 80% GPT-5.6 Luna y 50% la caché de GPT-6 Sol; Anthropic recortó 60% las lecturas de caché en Claude Opus 5.5.
- En agentes autónomos de programación y atención, la caché representa del 96% al 99% del gasto de tokens, multiplicando el ahorro real.
- Modelos de pesos abiertos como DeepSeek Flash V4.1 y Kimi K3.1 Pro en OpenRouter han roto el monopolio de precios de cara a las salidas a bolsa (IPO).
La era de pagar sumas astronómicas por inteligencia artificial de primer nivel ha llegado a su fin. En una carrera implacable por retener a desarrolladores y corporaciones, OpenAI y Anthropic han reducido hasta un 80% las tarifas de sus modelos insignia en apenas cuatro meses. El detonante detrás de este desplome no es la generosidad corporativa, sino una fuerza de mercado imparable: los modelos de pesos abiertos marcan hoy el piso de precios y han transformado la inferencia avanzada en una infraestructura de bajo costo.
Qué acaba de cambiar exactamente en las tarifas de OpenAI y Anthropic
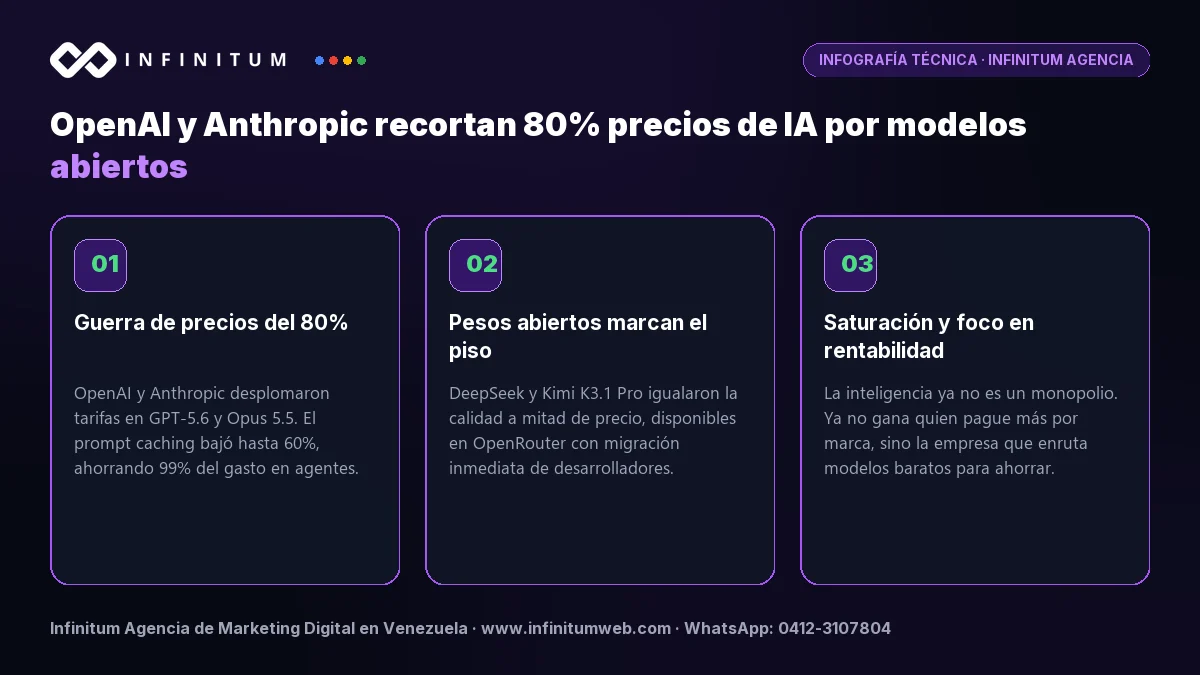
Durante los últimos cuatro meses, la industria de la inteligencia artificial ha experimentado el ajuste de precios más drástico desde el lanzamiento público de ChatGPT. Los recortes comenzaron el 30 de julio, cuando OpenAI redujo un 80% el costo de GPT-5.6 Luna, dejándolo en 20 centavos de dólar por millón de tokens de entrada y 1,20 dólares por millón de tokens de salida [1], además de rebajar un 20% su modelo GPT-5.6 Terra ante la creciente sensibilidad de las empresas hacia el gasto operativo.
La respuesta de Anthropic no se hizo esperar: el 22 de septiembre introdujo Claude Opus 5.5 a 4 y 20 dólares por millón de tokens de entrada y salida, respectivamente (un 20% menos que su predecesor), complementado con una rebaja del 60% en las lecturas de caché (*prompt caching*) [2]. Ese mismo día, OpenAI presentó GPT-6 Sol a mitad de precio y, una semana más tarde, lanzó GPT-6.1 Sol con un 50% de descuento adicional en lectura de caché [3]. Según documentó el científico de datos Max Woolf, en los agentes de programación y flujos de trabajo autónomos las lecturas de caché representan entre el 96% y el 99% del consumo total, por lo que el impacto económico real para las empresas supera con creces el descuento nominal publicado en las tablas comerciales.
Por qué los modelos de pesos abiertos forzaron este desplome histórico
El motor detrás de esta deflación acelerada reside en la madurez y distribución masiva de los modelos de pesos abiertos (*open weights*). Woolf ilustró este fenómeno con el caso de DeepSeek Flash V4.1, un modelo que en mayo era ofrecido por 13 proveedores en OpenRouter y que hoy está disponible a través de 29 empresas distintas [4], incluyendo plataformas globales como Cloudflare y DeepInfra con márgenes de intermediación inferiores al 10% respecto a los precios del laboratorio original.
A esta presión se suma la irrupción de Moonshot AI con el lanzamiento de Kimi K3.1 Pro a 2 dólares por millón de tokens de entrada y 10 dólares de salida (la mitad del costo de Claude Opus 5.5) [5], prometiendo además la liberación total de sus pesos bajo licencia abierta. Como sentenció con agudeza Russell Kaplan, presidente y cofundador de Cognition (creadores del agente Devin): muchas tareas de ingeniería de software han alcanzado un punto de ‘saturación de inteligencia’ donde múltiples modelos resuelven el problema con idéntica solvencia, convirtiendo el costo por token y la latencia en las únicas variables decisivas [6]. Esta comoditización amenaza los ingresos proyectados por OpenAI y Anthropic justo cuando ambas firmas preparan sus prospectos S-1 para salir a bolsa en Wall Street.
Para organizaciones que buscan capitalizar estas tendencias con resultados medibles, apoyarse en nuestro soluciones de inteligencia artificial y automatización para empresas permite acelerar la implementación técnica y convertir la visibilidad en clientes reales.
Qué debes hacer hoy en tu negocio en Venezuela y Latinoamérica
Para los empresarios, directores de tecnología y comercios en Venezuela y Latinoamérica, este ajuste marca el momento exacto para auditar el presupuesto digital y erradicar gastos superfluos. Si tu organización continúa pagando planes corporativos fijos o licencias en dólares sin aprovechar el enrutamiento dinámico de modelos, estás absorbiendo un sobrecosto operativo injustificado.
La estrategia óptima consiste en implementar una arquitectura híbrida: asignar modelos ultraligeros y económicos (DeepSeek, GPT-5.6 Luna o Kimi) para la clasificación de datos, atención de primer contacto en WhatsApp y filtrado de consultas frecuentes, reservando modelos de frontera exclusivamente para razonamiento estratégico de alta complejidad. Al integrar esta infraestructura con un sitio web corporativo optimizado y pasarelas de comercio conversacional, las empresas locales pueden multiplicar su capacidad de prospección y cierre comercial con un costo marginal cercano a cero.
Comparativa Estratégica: Enfoque Tradicional vs. Nuevo Estándar 2026
| Dimensión Operativa | Enfoque Tradicional | Nuevo Estándar 2026 | Ecosistema Infinitum |
|---|---|---|---|
| Coste de Inferencia (1M Tokens) | Tarifas rígidas de $20 a $60 por millón sin opciones de descuento. | Modelos de alto rendimiento desde $2 a $4 con descuentos de hasta 80%. | Arquitectura de enrutamiento dinámico para mínima latencia y menor costo. |
| Impacto del Prompt Caching | Facturación íntegra de contexto repetido en cada llamada. | Rebajas de 50% a 60% en caché, reduciendo el 99% del gasto en agentes. | Optimización de memoria y caché en bases de datos vectoriales propietarias. |
| Riesgo de Dependencia (Lock-in) | Cautiverio tecnológico en la API de un único proveedor cerrado. | Inferencia flexible vía OpenRouter con pesos abiertos intercambiables. | Ecosistema multimodelo soberano, integrado a tu web, CRM y WhatsApp. |
| Facturación y Cumplimiento | Cargos exclusivos en tarjetas internacionales sin soporte local. | Plataformas de prepago en cripto o dólares sin aval contable regional. | Facturación fiscal legal SENIAT (RIF: J-50392044-0) a tasa oficial BCV. |
Preguntas Frecuentes (FAQ)
1. ¿Por qué OpenAI y Anthropic bajaron sus precios hasta un 80% en tan poco tiempo?
La proliferación de modelos de pesos abiertos de alto rendimiento (como DeepSeek y Kimi K3.1 Pro de Moonshot AI) y su disponibilidad en plataformas de enrutamiento como OpenRouter permitieron a los desarrolladores migrar cargas de trabajo a costos mínimos, forzando a los gigantes cerrados a recortar márgenes para no perder cuota de mercado.
2. ¿Qué es el prompt caching y por qué genera tanto ahorro en agentes de IA?
Es una tecnología que almacena temporalmente fragmentos de texto o instrucciones que el modelo ya ha procesado para no volver a cobrarlos a tarifa completa. En agentes autónomos que leen repositorios de código o historiales extensos de chat, la caché representa entre el 96% y el 99% del consumo, por lo que una rebaja del 60% en caché desploma la factura final.
3. ¿Cómo afecta este cambio a las empresas que operan en Venezuela?
Representa una oportunidad inmensa de ahorro y competitividad. Permite desplegar asistentes inteligentes en WhatsApp, atención comercial 24/7 y automatización de procesos internos con una inversión mensual sumamente baja y sin requerir infraestructura de servidores costosa.
4. ¿Cómo ayuda Infinitum Agencia a integrar esta tecnología con respaldo local?
En Infinitum diseñamos e implementamos ecosistemas web, automatizaciones comerciales y agentes de inteligencia artificial a medida con enrutamiento inteligente de modelos. Ofrecemos facturación fiscal legal SENIAT (RIF: J-50392044-0) a tasa oficial BCV y soporte técnico presencial y remoto.
💡 En Resumen: Lo que debes recordar
- ✓ El desplome conjunto en tokens base y lecturas de caché reduce hasta un 75% el coste real de operar agentes de inteligencia artificial.
- ✓ La facilidad para alternar entre proveedores de inferencia en plataformas multi-modelo ha destruido la capacidad de fijación de precios de los gigantes cerrados.
- ✓ Adoptar enrutamiento inteligente de modelos permite a las empresas venezolanas operar asistentes 24/7 en WhatsApp y Web con un ahorro superior al 70%.
¿Quieres automatizar la atención y ventas de tu empresa con IA al menor costo?
Implementamos asistentes inteligentes en Instagram, Web y WhatsApp con base de conocimiento propia, enrutamiento multi-modelo y cero riesgo de bloqueos. Facturación fiscal SENIAT (RIF: J-50392044-0) a tasa oficial BCV. Facturación fiscal SENIAT (RIF: J-50392044-0) a tasa oficial BCV.
🚀 ¡Nunca pares de aprender!
Descubre más artículos clave en nuestro blog para seguir impulsando tu conocimiento: